內容再利用
這是什麼
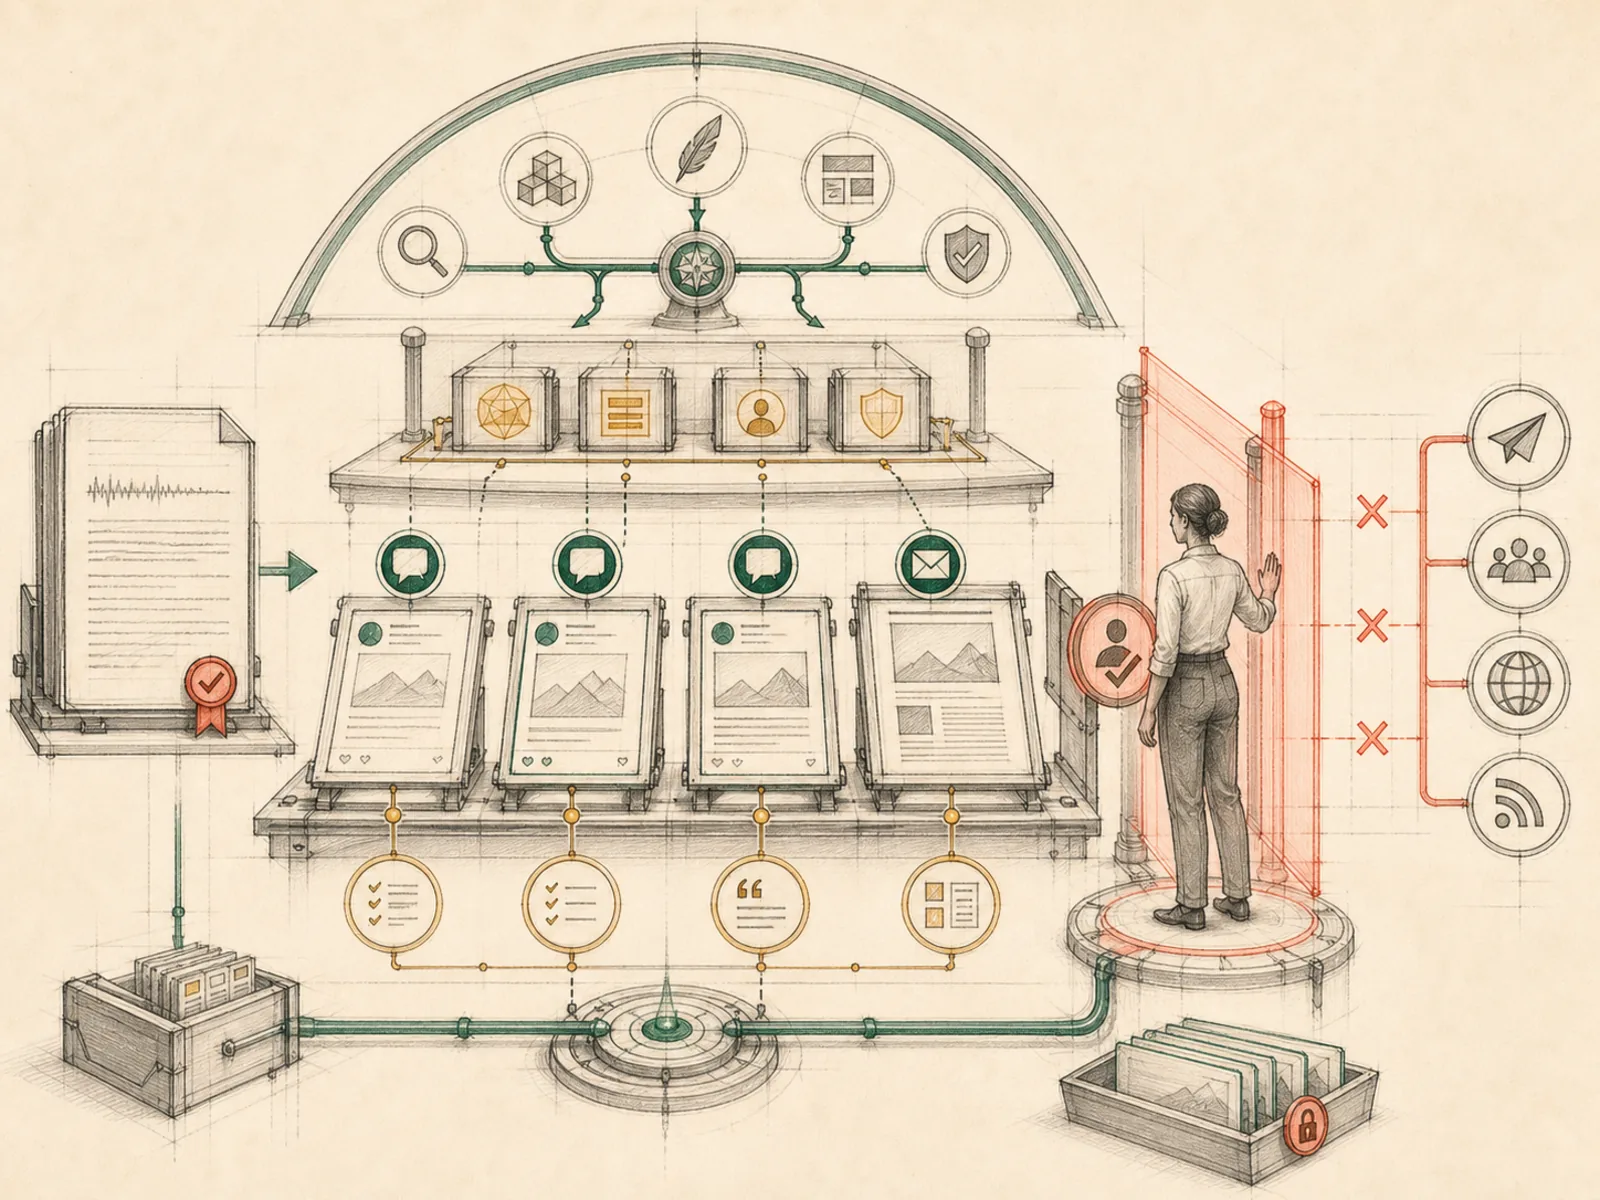
這套流程會把已核准素材改寫成多種格式,成品只會存成待審草稿,不具自動發布能力。
白話解釋
可以把它想成沒有送貨車的印刷店:店家能把一篇演講排成海報、傳單或名片,但成品只會留在櫃台,直到有人親自取走。內容再利用也是如此;它把一份素材改寫成其他格式的草稿,完成後便停止,因為這組工具本身沒有發布能力。
為什麼重要
此模式可用的檔案工具恰好只有 read_file、write_file、patch、search_files 四個,沒有任何一個能傳送或發布內容。因此,即使指示要求上線,建立在這組工具上的再利用 skill 也只能把 X、LinkedIn 或電子報版本放入審閱佇列。這不是因為發布前才彈出權限確認;寫入路徑的安全防護保護的是 SSH key、.env、token 儲存區等憑證檔案,而不是一般草稿。發布必須由人員或另一個具有不同權限範圍的 skill 另行執行。
運作方式
此模式會串接一般檔案工具。read_file 從逐字稿、文章或腳本讀入來源素材,並為大型文件提供行號與分頁(tools/file_tools.py)。若工作由既有 skill 文件引導,skill_view 會先載入完整指示,包括特定平台的語氣、長度與格式(tools/skills_tool.py)。write_file 接著建立存放改寫草稿的新檔案;如果目標路徑已存在,它會完整取代原內容,而不是就地編輯。審閱者提出小幅文字調整後,可由 patch 以模糊比對套用修改;search_files 則按內容或檔名尋找來源與既有草稿,取代 grep 或 ls 的用途。四個工具都沒有網路呼叫或 send 動作,所以流程一定停在磁碟上的檔案。
具體範例
有人把 40 分鐘的 Podcast 逐字稿存成文字檔,希望改寫成三篇 LinkedIn 貼文與一段電子報短文:
- 他把逐字稿路徑與四份成品要求交給 Hermes。
- Hermes 用
read_file讀取逐字稿,再建立linkedin-1.md、linkedin-2.md、linkedin-3.md、newsletter-blurb.md四份草稿。 - 系統不會把內容發布到任何地方;四個檔案只留在專案資料夾。
- 人員審閱後要求調整
linkedin-2.md,Hermes 用patch修改,最後仍由人員自行把定稿貼到LinkedIn。
如何連結
「內容再利用」屬於「工作流程模式」系列,最直接相關的概念包括「儲存庫監控」、「Slack 第二大腦」與「代理執行環境」。
來源證據
toolsets.py#<file>—toolset:file的來源圖譜結構性備援;確認檔案工具集與工具註冊來源檔的關聯,不單獨證明內部呼叫順序。toolsets.py#<file>—toolset:skills的來源圖譜結構性備援;確認 skill 工具集與工具註冊來源檔的關聯,不單獨證明內部呼叫順序。