上下文壓縮
這是什麼
在累積 token 達到依模型上下文視窗設定的門檻時,將較舊訊息濃縮成有損摘要並保留近期原文的程序;不必等到上下文已經塞滿才會執行。
白話解釋
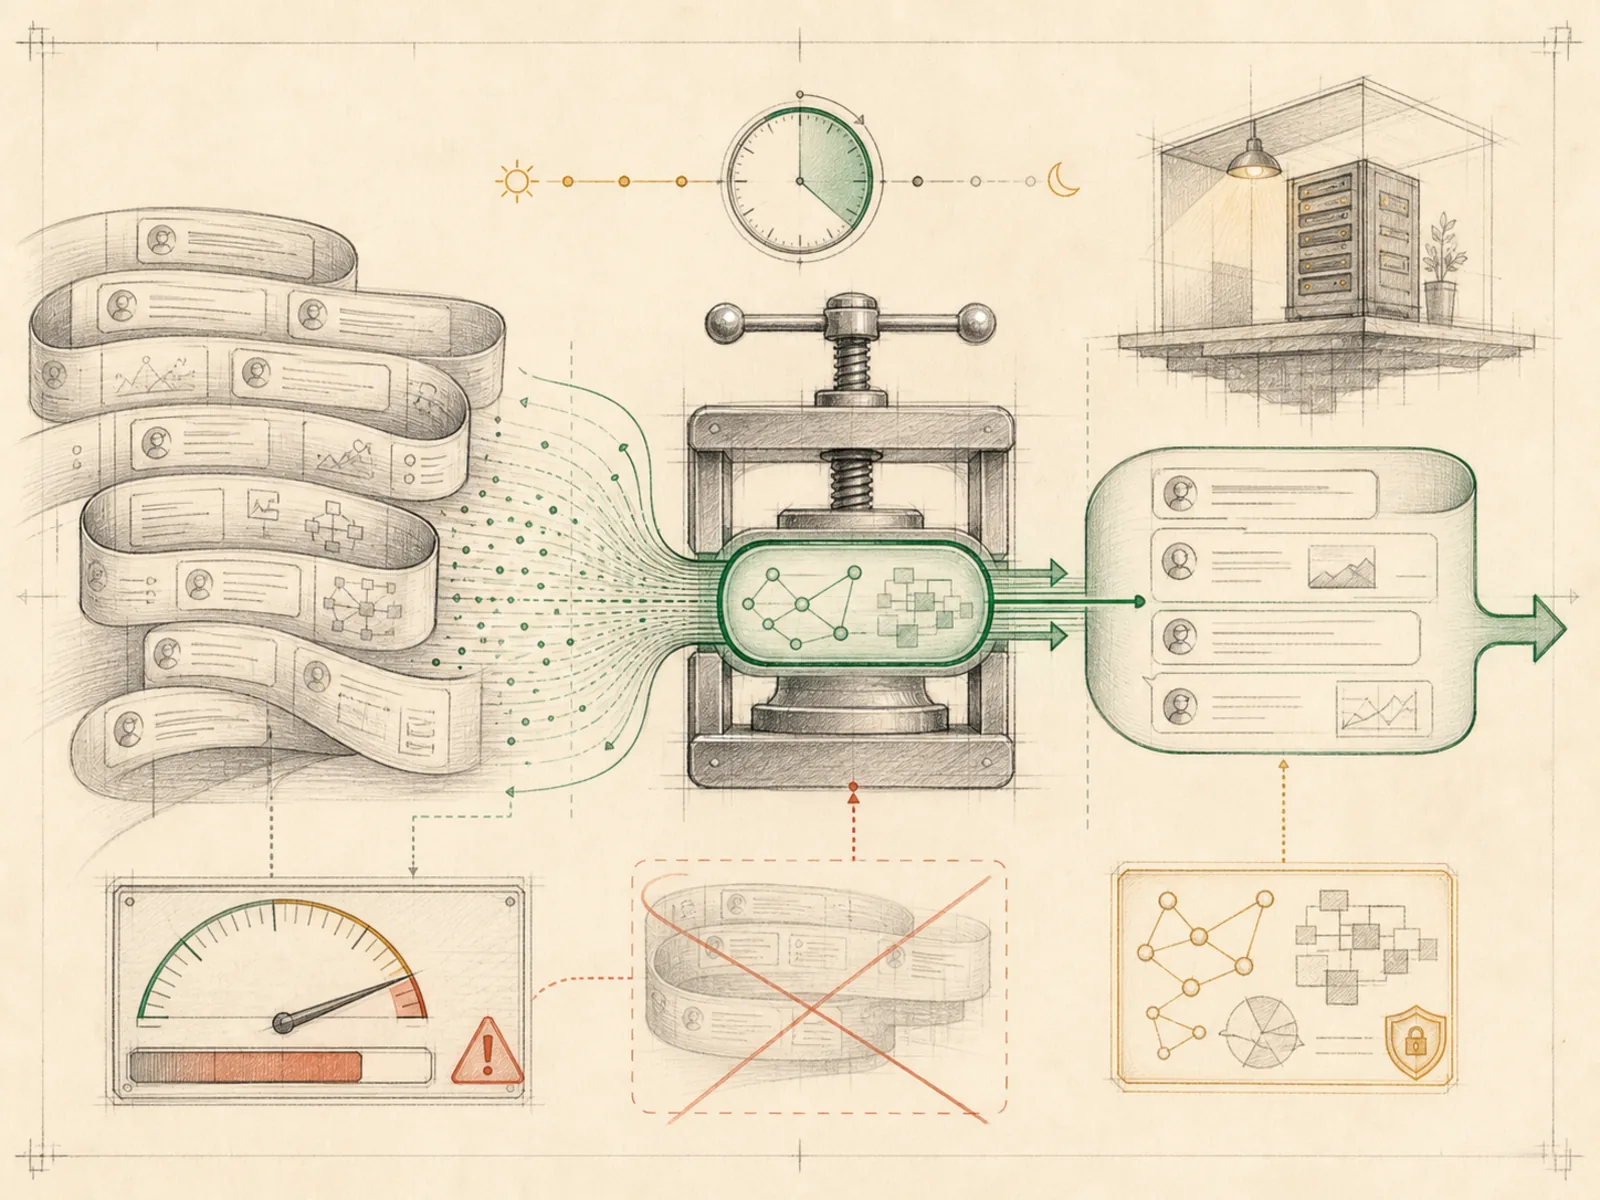
這就像長時間會議結束後整理會議紀錄:記錄者不會因為新討論增加,就直接刪除前兩小時內容,而是把較早段落濃縮成摘要,同時完整保留最近的發言。上下文壓縮也會把舊對話折疊成較短版本,而不是整段直接丟棄。
為什麼重要
持續數天的工作階段會快速累積歷史,逼近上下文限制;壓縮會在 token 超過門檻時,以模型撰寫的摘要取代較舊細節,控制成長速度。這份摘要刻意是有損資料,不是權威逐字稿:它可能遺漏或扭曲細節,反覆壓縮後尤其如此。需要核對早期訊息或工具呼叫原文時,仍應查看 SQLite 工作階段記錄。
運作方式
agent/context_compressor.py 的 ContextCompressor.should_compress 會依目前模型的上下文視窗大小設定門檻,檢查累積 token;若最近幾次壓縮幾乎沒有減少內容,保護機制會暫緩再次壓縮。觸發後,compress() 先把舊工具輸出裁成單行摘要,例如把完整記錄縮成「執行 npm test → 結束碼 0」;接著保留系統提示詞與依 token 預算計算的近期對話尾端,再透過 agent/auxiliary_client.py 的獨立摘要呼叫處理中間內容。預設會沿用目前對話使用的同一模型,不會暗中把輔助工作切換到較便宜的模型;操作員也可以另設專用摘要模型。再次壓縮時會迭代更新既有摘要,而非從頭開始。最後,摘要會以僅供參考的背景資料標籤放回上下文,避免模型把早期已摘要的要求誤認為仍待執行的工作。
具體範例
一個在 VPS 上執行的工作階段持續了 4 天,對話已超過模型舒適的上下文大小。下一個回合開始前,Hermes 先把數十筆舊工具呼叫記錄裁成單行,完整保留最近一段對話,再用一次摘要呼叫把更早內容整理成數段結構化文字。這個回合會因回覆前多一次摘要呼叫而稍慢,但模型之後能同時看到第 1 天的摘要與 1 小時前的完整細節,不必處理 4 天的原始逐字記錄。
如何連結
「上下文壓縮」屬於「執行期」系列。最直接相關的概念包括:「重試與備援」、「對話狀態」與「個人作業系統」。
來源證據
agent/conversation_loop.py#agent.conversation_loop.run_conversation— 已驗證的run_conversationSource Map證據。對話迴圈會把目前提示詞與臨時提示詞放入第一則系統訊息,依api_messages建立提供者請求參數,並讓代表性的串流分支經過大型語言模型執行中介層後呼叫_interruptible_streaming_api_call。
工作流程
- 目前尚無第一輪工作流程對應;此概念仍透過文章與來源證據出現在知識庫圖譜中。